NVIDIA представила Kumo Relational: предсказания по базам данных без обучения
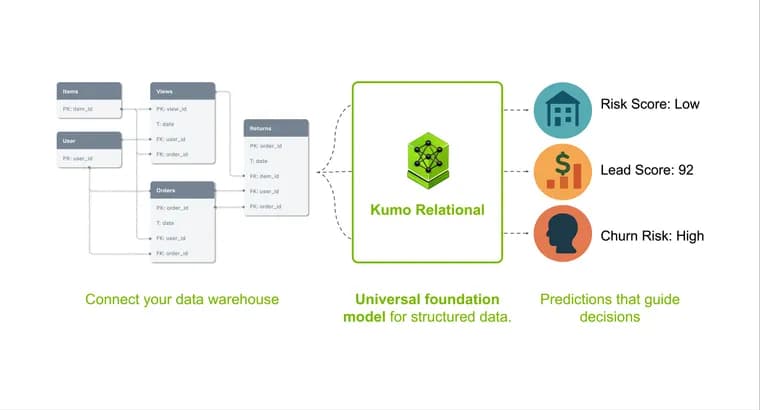
NVIDIA вместе с командой Kumo представила Kumo Relational, предобученную фундаментальную модель для реляционных данных. Она делает предсказания (отток клиентов, спрос, мошенничество и т. п.) прямо по корпоративной базе данных за один прямой проход, без обучения под конкретную задачу, без ручного конструирования признаков и без «сплющивания» таблиц в одну. Получив предсказательный запрос, модель собирает до 10 000 исторических примеров как контекст.
Авторы блога на Hugging Face называют Kumo Relational первой few-shot (обучающейся по нескольким примерам) фундаментальной моделью, которая превосходит обычное обучение с учителем на распространённых реляционных тестах. По их данным, на 41 задаче из 15 баз данных (RelBench V1 и V2, SAP SALT, 4DBInfer; области, электронная коммерция, медицина, корпоративные данные, соцсети, наука) она опережает обученные с учителем реляционные модели глубокого обучения и конвейеры на градиентном бустинге по деревьям с признаками, подготовленными экспертами. Ни один из этих наборов не встречался при предобучении.
Конкретные цифры из блога: на задачах классификации RelBench V1 модель опережает градиентный бустинг на экспертных признаках почти на 4 пункта AUROC в среднем. На корпоративном тесте SAP SALT она обходит XGBoost на инженерных признаках на 7 пунктов MRR (средний обратный ранг) сразу «из коробки» и на 13 пунктов после дообучения; ансамбли AutoGluon, на 8% по MRR (в источнике не уточнено, относительные это проценты или абсолютные), после дообучения отрыв растёт до 16%; недавние табличные фундаментальные модели, примерно на 25%. На рейтинге RelArena-α (RelBench V1) Kumo Relational лежит на границе Парето по соотношению точности и скорости: около 17 секунд на 1 000 примеров и Elo 1 842. Лучший по точности участник rt-plurel даёт Elo 1 878, но примерно в 430 раз медленнее (около 7 300 секунд). Модель, по тексту, хорошо работает даже при 0,2% обучающих данных в качестве контекста и остаётся устойчивой, если удалить до 75% связей по внешним ключам.
Устройство: модель учитывает таблицы, внешние ключи и временные метки. Каждый пример, локальный подграф вокруг сущности в момент времени с известным исходом. Задачи формулируются на декларативном языке Predictive Query Language (PQL): указывается, что предсказать, а не как. Для временных задач система воспроизводит прошлые состояния базы и подаёт модели только данные до опорной отметки времени, что, по словам авторов, исключает утечку данных. Внутри таблиц небольшая сеть чередует внимание по столбцам и по строкам; затем более крупная сеть распространяет эмбеддинги строк по связям первичных и внешних ключей с помощью графового внимания и внимания между примерами контекста. Так как работа идёт над эмбеддингами строк, а не над каждой ячейкой, квадратичной стоимости удаётся избежать.
Предобучение проводилось целиком на синтетических реляционных данных, потому что разнообразные реляционные базы редко бывают открытыми. Генератор опирается на подход PluRel (Kothapalli et al., ICML 2026); участники команды Kumo помогали разрабатывать PluRel и соавторствовали оригинальной статье. Обучение шло по этапам, от одиночных таблиц к всё более сложным структурам. При необходимости модель можно дообучить на конкретном наборе данных.
Ограничения, названные самими авторами: лучше всего модель работает на данных со значимыми связями и временной динамикой; на задачах с очень большими обучающими выборками специализированные обученные модели всё ещё могут её слегка обойти (в их тестах использовалось не более 10 000 примеров контекста), для этого предусмотрено дообучение; предсказательный сигнал должен быть достижим за ограниченное число переходов по связям, поэтому советуют начинать с узкого запроса по нескольким таблицам.
Доступность: модель входит в новую открытую библиотеку NVIDIA structured-data-models, оптимизированную под GPU (в ней же работает родственная модель Kumo Tabular); веса при первом запуске загружаются с Hugging Face Hub. Альтернатива, развернуть её как NVIDIA NIM и обращаться через открытый клиент structured-data-models-client, формулируя запрос на PQL (например, предсказать число заказов пользователя за 30 дней). Система заявлена как масштабируемая до баз с 500 млрд и более строк благодаря собственному графовому движку с отображением в память и пропускной способностью ввода-вывода до 5 ГБ/с. Авторы также подчёркивают, что модель рассчитана на вызов агентами.
Ключевые факты
- Kumo Relational, предобученная модель NVIDIA и команды Kumo для реляционных баз: прогноз за один прямой проход, без обучения под задачу и без конструирования признаков; контекст, до 10 000 исторических примеров.
- По данным авторов, на 41 задаче из 15 баз данных модель обходит обученные с учителем реляционные модели и конвейеры на градиентном бустинге; на RelBench V1, почти на 4 пункта AUROC в среднем, на SAP SALT, на 7 пунктов MRR против XGBoost (13 после дообучения).
- На рейтинге RelArena-α модель даёт Elo 1 842 за около 17 секунд на 1 000 примеров; лидер по точности (Elo 1 878) медленнее примерно в 430 раз.
- Предобучение велось целиком на синтетических реляционных данных; задачи пишутся на языке PQL; доступна в открытой библиотеке structured-data-models и как NVIDIA NIM.
- Все результаты получены самими авторами; они же признают, что на задачах с очень большими обучающими выборками специализированные модели могут быть чуть точнее.
Почему это важно
Прогнозы по реляционным базам (отток, спрос, мошенничество) обычно требуют недель подготовки признаков и обучения отдельного конвейера под каждую задачу. Авторы предлагают подход, знакомый по языковым моделям: одна предобученная модель вместо множества специализированных, а новый прогноз превращается в запрос, а не в проект. Заявленное превосходство над XGBoost, на котором держатся многие промышленные конвейеры, делает это претензией на замену привычного инструмента, но пока это утверждение самих авторов.
Кому это важно
Командам, которые делают прогнозы поверх корпоративных баз данных: аналитикам, ML-инженерам, разработчикам агентов, которым нужен способ «заглядывать вперёд» (например, какой клиент уйдёт). Также интересно тем, кто следит за фундаментальными моделями для структурированных данных и синтетическим предобучением.
Как это применить
Модель доступна двумя путями: через открытую GPU-библиотеку structured-data-models (pip install structured-data-models; веса подтягиваются с Hugging Face Hub при первом запуске, нужен CUDA-совместимый GPU) либо как развёрнутый NVIDIA NIM с клиентом structured-data-models-client, где задача пишется на PQL. Авторы советуют начинать с узкого запроса по нескольким нужным таблицам и расширять граф по мере необходимости; для максимальной точности, дообучать на своих данных. Цена, лицензия и требования к оборудованию в доступном тексте не указаны.
Можно ли доверять
Блог опубликован самими авторами (NVIDIA) на Hugging Face; результаты взяты из их собственной статьи (arXiv 2604.12596) и документации, независимого воспроизведения в тексте не приводится. Формулировка «первая few-shot фундаментальная модель, превосходящая обучение с учителем», заявление авторов. Сравнения опираются на публичные тесты (RelBench, SAP SALT, 4DBInfer), и авторы утверждают, что эти наборы не использовались при предобучении. Процент преимущества над AutoGluon (8% по MRR) в источнике не определён как относительный или абсолютный.
Риски и подводные камни
Сами авторы указывают: на задачах с очень большими обучающими выборками специализированные модели могут догонять или слегка обгонять предсказания в контексте; нужны значимые связи между таблицами и достижимость сигнала за ограниченное число переходов. Предобучение на синтетических данных не гарантирует, что модель одинаково хорошо справится с вашей конкретной базой. Заявленный масштаб в 500 млрд строк и скорость относятся к описанному авторами движку и их условиям; на своём оборудовании результаты нужно проверять отдельно.
«Подключите базу данных, опишите, что предсказать, и получите предсказания за один прямой проход. Обучение не требуется.»
— авторы блога NVIDIA на Hugging Face