Microsoft Research представила TokenEconomizer: ИИ-агенты для кода дешевле на 18,4-30,9%
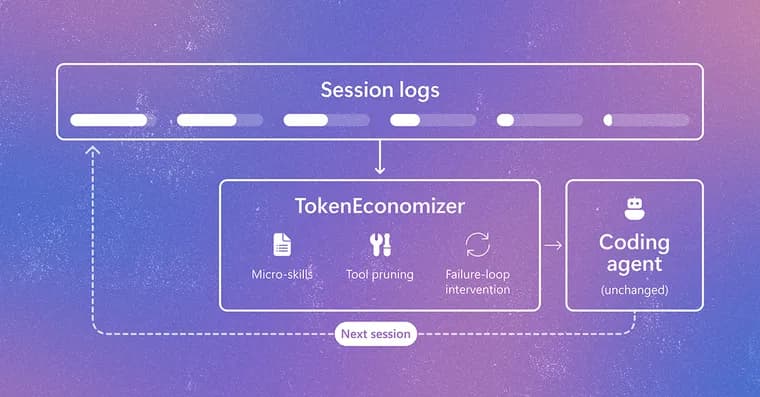
Microsoft Research опубликовала в блоге статью о TokenEconomizer, открытом плагине от UC Berkeley, Microsoft Research и Microsoft Security. Он учится на прошлых сессиях ИИ-агента в конкретном репозитории и уменьшает лишние траты токенов в будущих сессиях. При этом ни сам агент, ни его модель менять не нужно, поэтому плагин можно подключать к уже привычным агентам для программирования. Главный результат: на 277 реальных задачах по исправлению ошибок расходы снизились на 18,4-30,9% для разных ИИ-агентов; в каждом из протестированных репозиториев стоимость упала, а доля успешно решённых задач, по словам авторов, осталась в целом стабильной.
Исходная проблема в том, что разработчики снова и снова работают в одной и той же кодовой базе, а агент каждую сессию начинает с нуля: заново выясняет знакомые факты, загружает ненужные инструменты и повторяет неудачные подходы. Каждое обращение к модели расходует токены: агент отправляет инструкции, описания инструментов и историю сессии. Чтобы понять, куда уходят токены, авторы сначала проанализировали Claude Code на 60 задачах из SWE-Bench (набор реальных исправлений ошибок в открытых Python-проектах), прогоняя задачи каждого репозитория последовательно. Нашлись три повторяющихся источника потерь. Первый, повторное открытие одних и тех же фактов: когда в репозитории накопилось не менее пяти выполненных задач, 30% вызовов инструментов повторяли действие из более ранней задачи в этом же репозитории, а совпадений с историей другого репозитория было лишь 7%. Второй, оплата неиспользуемых инструментов: агент получал описания 23 инструментов в каждом ходе, но 16 из них ни разу не вызывались. Третий, застревание на сбоях: 17% задач, которые не удалось решить, дали 32% всех расходов. Кроме того, авторы проверили три популярных открытых плагина для экономии, каждый из которых построен на фиксированной стратегии: каждый снижал расходы в одних репозиториях, но не в других. Отсюда вывод авторов: контроль стоимости должен подстраиваться под репозиторий, а не применять везде одну стратегию.
Как это работает. После каждой сессии TokenEconomizer читает её журнал и обновляет знания о репозитории, а затем действует через три механизма, пользуясь только интерфейсами, которые агент уже предоставляет. Микронавыки, однострочные заметки о специфике репозитория: плагин находит повторяющиеся закономерности в сессиях и предлагает соответствующие заметки; в стартовый контекст агента они попадают лишь после того, как закономерность подтвердили несколько сессий, а если позже появляются противоречащие данные, заметка снимается. Отсечение инструментов убирает те, которыми агент, судя по истории репозитория, вряд ли воспользуется; базовые инструменты для запуска команд и правки файлов остаются всегда, а убранные при необходимости можно вернуть. Вмешательство при зацикливании на сбоях следит за агентом, который раз за разом упирается в одну и ту же ошибку: модель-судья решает, действительно ли он застрял или всё ещё продвигается; если застрял, агент получает короткую заметку с предложением попробовать другой подход, а в открытом плагине при дальнейшем застревании разработчика уведомляют, не останавливая работу самостоятельно. Контроллер пересматривает свои решения по мере поступления новых данных, а заявленная экономия учитывает и стоимость собственных обращений TokenEconomizer к моделям.
Оценка. Плагин проверили на 277 задачах SWE-Bench из шести репозиториев с пятью разными комбинациями ИИ-агента и модели; для каждого репозитория TokenEconomizer начинал без истории прошлых сессий. Средняя стоимость снизилась на 18,4-30,9%, и во всех 30 парах «репозиторий, комбинация» он, по словам авторов, дал наибольшую экономию без потери качества. Для сравнения, снижение глубины рассуждений модели экономило столько же или больше, но приводило к заметному падению качества. Экономия растёт с накоплением опыта: первые задачи могут обходиться дороже, пока плагин учится, но накопленные расходы опускались ниже базового уровня в каждом репозитории к шестой задаче. Каждый механизм даёт экономию и сам по себе, а наибольший эффект даёт сочетание всех трёх. Результат переносится и на другие сценарии: на Web-Bench (последовательная веб-разработка) расходы ниже на 16,0-21,2%, а при аудите безопасности, где каждая задача идёт в новом репозитории, на 6,4-19,6%.
Плагин рассчитан на работу рядом с существующими ИИ-агентами без изменения их моделей, не требует собственного ключа API и хранит накопленные знания на машине разработчика. Авторы приглашают сообщество использовать его как отправную точку для агентов, которые становятся изобретательнее с опытом.
Ключевые факты
- TokenEconomizer, открытый плагин от UC Berkeley, Microsoft Research и Microsoft Security: он учится на прошлых сессиях агента в репозитории, не меняя ни агента, ни его модель.
- На 277 задачах SWE-Bench из шести репозиториев с пятью комбинациями агента и модели средняя стоимость снизилась на 18,4-30,9%, а доля решённых задач, по словам авторов, осталась в целом стабильной.
- Профилирование Claude Code на 60 задачах: 30% вызовов инструментов повторяли действия из прошлых задач того же репозитория, 16 из 23 описаний инструментов ни разу не вызывались, а 17% неудачных задач дали 32% расходов.
- Три механизма: микронавыки (однострочные заметки о репозитории), отсечение редко нужных инструментов и вмешательство при зацикливании на сбоях с участием модели-судьи.
- На Web-Bench расходы ниже на 16,0-21,2%, на аудите безопасности (каждая задача в новом репозитории), на 6,4-19,6%.
Почему это важно
Расход токенов, одна из главных статей затрат при работе с ИИ-агентами для программирования, а большинство способов экономии, по словам авторов, нацелены на отдельные задачи. TokenEconomizer использует то, что разработчики возвращаются в одни и те же репозитории: опыт прошлых сессий превращается в подсказки для следующих. Профилирование показало, где именно теряются токены: повторное открытие знакомых фактов, неиспользуемые описания инструментов и затяжные попытки исправить одну и ту же ошибку.
Кому это важно
Разработчикам и командам, которые ежедневно работают с ИИ-агентами в одной кодовой базе и оплачивают токены. Также исследователям агентных систем: подход «чёрного ящика» не требует доступа к весам или коду агента и опирается только на уже доступные агенту интерфейсы.
Как это применить
Плагин открытый и рассчитан на работу рядом с существующими агентами: он не требует собственного ключа API, а накопленные знания хранит на машине разработчика. В тексте блога нет ссылки на репозиторий, сведений о лицензии и инструкций по установке, поэтому за ними стоит обращаться к самой статье «TokenEconomizer: Experience-Driven Black-Box Cost Control for Coding Agents». Практический вывод из результатов: выгода растёт с накоплением опыта, и к шестой задаче накопленные расходы опускались ниже базового уровня в каждом репозитории.
Можно ли доверять
Это материал блога самих авторов (Microsoft Research) о собственной работе, все цифры получены ими же. Заявленная экономия учитывает стоимость собственных вызовов моделей плагином, а сравнение с тремя популярными открытыми плагинами и со снижением глубины рассуждений добавляет контекст. Но в тексте не названы шесть репозиториев, пять комбинаций агента и модели и три сравниваемых плагина, нет абсолютных затрат в деньгах и токенах, а изменение доли решённых задач описано лишь как «в целом стабильное» без числа. Независимой проверки в тексте нет.
Риски и подводные камни
Основные результаты получены на SWE-Bench, исправлениях ошибок в открытых Python-проектах; на другом материале эффект может отличаться (на Web-Bench и в аудите безопасности экономия меньше). Каждый репозиторий начинался без истории, и на первых задачах расходы могут быть выше базовых, пока плагин учится. Снижение глубины рассуждений экономило столько же или больше, но заметно ухудшало качество, то есть дешевле не всегда лучше. В открытом плагине при затянувшемся застревании агента разработчик получает уведомление, а не автоматическую остановку работы.