LynnReal-Omni объединяет генерацию видео из текста, 3D-сцен и игр
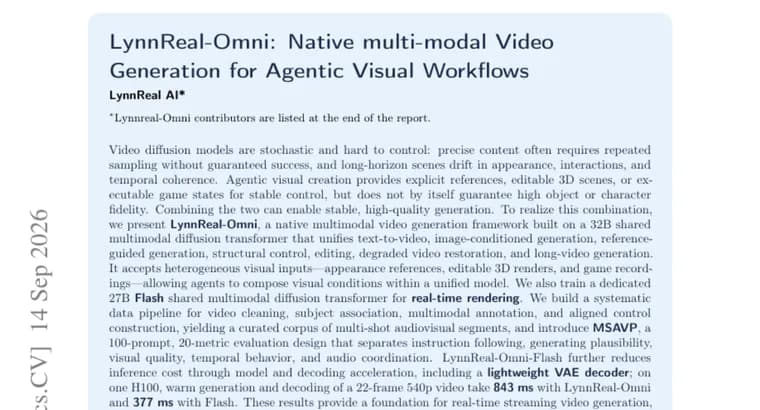
Диффузионные модели видео стохастичны и плохо поддаются точному контролю: чтобы получить нужное содержание, часто нужны повторные попытки без гарантии успеха, а на длинных роликах плывут внешний вид объектов, их взаимодействия и временная согласованность сцены. Агентные подходы к созданию видео, явные визуальные референсы, редактируемые 3D-сцены, исполняемые игровые состояния, дают стабильный контроль над сценой, но сами по себе не гарантируют высокую точность воспроизведения объектов и персонажей. По утверждению авторов, сочетание двух подходов способно дать одновременно стабильную и качественную генерацию.
Для этого они представили LynnReal-Omni, «нативный» мультимодальный фреймворк генерации видео на базе общего 32-миллиардного мультимодального диффузионного трансформера. Модель объединяет в себе генерацию видео по тексту, генерацию с опорой на изображение, генерацию по визуальным референсам, структурный контроль сцены, редактирование, восстановление повреждённого видео и генерацию длинных роликов. На вход она принимает разнородные визуальные данные, референсы внешнего вида, редактируемые 3D-рендеры и записи игрового процесса, что позволяет агентам комбинировать разные визуальные условия в рамках одной модели вместо переключения между отдельными инструментами.
Отдельно авторы обучили 27-миллиардную Flash-версию для рендеринга в реальном времени: она снижает стоимость вывода за счёт ускорения самой модели и этапа декодирования, включая облегчённый VAE-декодер. На одном GPU H100 «прогретая» генерация и декодирование 22-кадрового видео в разрешении 540p занимают 843 мс на базовой модели LynnReal-Omni и 377 мс на Flash-версии.
Для обучения авторы построили систематический пайплайн обработки данных: очистку видео, связывание объектов между кадрами, мультимодальную разметку и построение согласованных управляющих сигналов, на выходе получился курируемый корпус многосюжетных аудиовизуальных фрагментов. Также представлен собственный оценочный набор MSAVP: 100 промптов и 20 метрик, разделяющих точность следования инструкции, правдоподобие генерации, визуальное качество, временную согласованность и синхронизацию звука с изображением.
По словам авторов, полученные результаты закладывают основу для потоковой генерации видео в реальном времени и делают LynnReal-Omni единой, управляемой и эффективной базой для агентного создания визуального контента.
Ключевые факты
- LynnReal-Omni, фреймворк генерации видео на базе 32-миллиардного мультимодального диффузионного трансформера, объединяющий генерацию по тексту, изображениям и 3D-референсам, редактирование, восстановление повреждённого видео и генерацию длинных роликов в одной модели.
- Модель принимает разнородные визуальные входы, референсы внешнего вида, редактируемые 3D-рендеры и записи игрового процесса, позволяя агентам комбинировать условия генерации внутри одной системы.
- Отдельная 27-миллиардная Flash-версия ускоряет вывод за счёт оптимизации модели и декодирования, включая облегчённый VAE-декодер, и рассчитана на рендеринг в реальном времени.
- На одном GPU H100 генерация и декодирование 22-кадрового 540p-видео занимают 843 мс на базовой модели и 377 мс на Flash.
- Авторы представили MSAVP, набор из 100 промптов и 20 метрик, оценивающий следование инструкции, правдоподобие, визуальное качество, временную согласованность и синхронизацию звука.
Почему это важно
Диффузионные модели видео стохастичны, и точный контроль над содержанием часто требует повторных попыток без гарантии успеха, а на длинных роликах плывут внешний вид, взаимодействия объектов и временная согласованность сцены. Агентные подходы, явные референсы, редактируемые 3D-сцены, исполняемые игровые состояния, дают стабильный контроль, но сами по себе не гарантируют высокую точность воспроизведения объектов и персонажей. LynnReal-Omni, попытка объединить оба подхода в одной модели, чтобы получить одновременно стабильность и качество генерации.
Кому это важно
Разработчикам агентных инструментов создания видео, командам, которые строят пайплайны генерации на основе 3D-сцен или игровых движков, и исследователям в области видеогенерации: модель показывает архитектуру, где одна система закрывает сразу несколько задач, текст-в-видео, генерацию по референсам, редактирование, восстановление и генерацию длинных роликов, вместо набора отдельных узкоспециализированных инструментов.
Как это применить
Модель принимает на вход текст, изображения, референсы внешнего вида, редактируемые 3D-рендеры и записи игрового процесса, что позволяет агентам комбинировать разные визуальные условия в рамках одной модели. Для сценариев, где важна скорость, есть отдельная Flash-версия: на одном H100 она генерирует и декодирует 22-кадровое 540p-видео за 377 мс против 843 мс у базовой модели, авторы называют это основой для потоковой генерации видео в реальном времени.
Можно ли доверять
Материал, аннотация (abstract) препринта, а не пересказ по обрывочным данным. При этом в самом тексте нет имён авторов и организаций, нет сравнения с конкурирующими моделями генерации видео и нет сведений об объёме и составе обучающих данных или вычислительных затратах на обучение. Оценочный набор MSAVP, собственная разработка авторов, и его соотношение с уже существующими бенчмарками видеогенерации в тексте не приводится.
Риски и подводные камни
Без сравнения с другими моделями сложно судить, насколько заявленные качество и скорость выделяются на фоне конкурентов. В тексте не сообщается, будут ли открыты код или веса модели, оценить доступность и воспроизводимость результата нельзя. Отдельный риск общего характера: модели, которые объединяют референсы, 3D-сцены и игровые записи в реалистичное видео, расширяют возможности для синтетического контента, но сам текст эту тему не затрагивает.