Linum выпустила P-JiT: нейросеть для картинок за $21 тыс. обучения
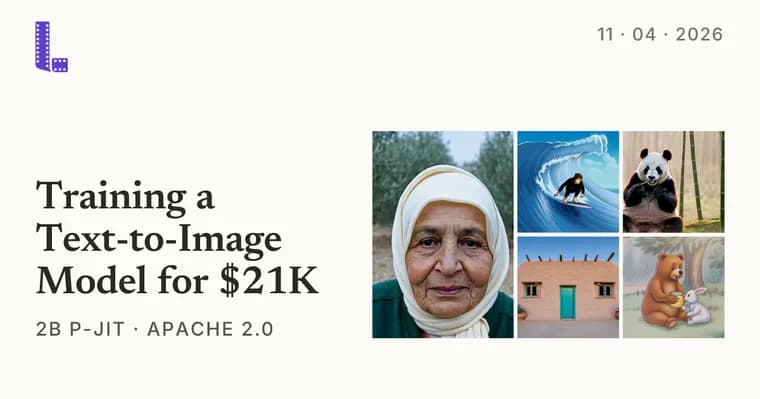
Linum, исследовательская лаборатория из двух человек, которая с нуля обучает собственные модели генерации видео. Цель, по их словам, творческие инструменты, делающие анимацию доступной. Новая модель для генерации картинок по тексту, Pyramid-JiT (P-JiT), для них проверка концепции на пути к следующей видеомодели: обучение обошлось примерно в $21 тыс. (в заголовке на Hacker News, «около $20 тыс.»). Авторы удивились, насколько хорошо выглядят результаты при таком размере модели, и решили выложить её как экспериментальный релиз. В заголовке публикации на Hacker News указано, что веса открыты по лицензии Apache 2.0.
Идея Linum: узкое место обучения и работы видеомоделей, внимание со сложностью O(n²), поэтому чем сильнее сжать данные, тем дешевле обучение и генерация. Обычно сжатием занимается отдельная модель вроде вариационного автокодировщика (VAE), но у VAE, по наблюдениям авторов, есть эмпирический потолок сжатия, а улучшение VAE в задаче реконструкции может ухудшать генерации downstream-диффузионной модели. Поэтому они отказались от VAE: диффузионная модель сама учит скрытое пространство под свою задачу и работает прямо в пространстве пикселей.
Из предыдущих работ Linum: P-JiT сходится в 11 раз быстрее по числу образцов, чем Linum v2, при вчетверо более агрессивном сокращении токенов, изображение 512² представлено тем же числом токенов, что раньше 256². Секрет в двух вещах: подобранном расписании шума для пиксельных моделей, которое помогает выучивать мелкие детали, и «считывателях» (readouts) вдоль основного ствола DiT. Поскольку модель работает в пикселях, каждый блок буквально предсказывает версию итоговой картинки; предсказание версий в низком разрешении усиливает градиентный сигнал в ранних блоках и ускоряет сходимость. Для проверки на прочность модель обучали дольше: около 600 млн образцов вместо 50-100 млн в первых экспериментах.
Архитектура. Текст и изображение сначала проходят по два однотипных «уточняющих» DiT-блока, затем объединяются в один поток из 22 одинаковых блоков. Размер модели: DiT на 2 млрд параметров и текстовый кодировщик на 4 млрд. Текстовое представление берётся из замороженной Qwen3.5-4B на слоях 7, 15 и 27 (три слоя с полным вниманием). Изображение режется на патчи 32×32 и сжимается в 1024-мерное пространство. После блока 5 стоит двухслойный считыватель PixelREPA, выравнивающий скрытое пространство с DINOv3-L; после блоков 10 и 16, два линейных считывателя, предсказывающих чистое изображение в четверти и половине разрешения. Итоговая функция потерь, MSE на считывателях, косинусное расстояние PixelREPA, MSE на выходе и перцептивные потери на полноразмерной картинке (LPIPS и P-DINO). Условие по шагу шума подаётся через низкоранговый AdaLN, как в Z-Image: эмбеддинг шага сжимается до 256 измерений, а у каждого блока свои масштаб и затвор с нулевой инициализацией, так что каждый блок стартует как тождественное преобразование.
Расписание обучения. Первые 80 млн образцов шум сосредоточен на высоких уровнях, модель учит базовую структуру; затем распределение шума расширяют, чтобы она училась мелким деталям. Усреднение весов (EMA) включается на 100 млн образцов. При переходе на 1024² оптимизатор запускают заново, обучение продолжают с весов EMA от 512², масштаб шума удваивают с 2 до 4 (избыточность информации при высоком разрешении), применяют интерполяцию RoPE, а EMA на 1024² стартует через 2 млн образцов после перехода.
Дообучение. Использовали вариант Finite Difference Flow Optimization (FDFO) с JEV-Image и судьями с участием человека. Авторы отмечают, что постобучение диффузионных моделей, очень молодая область: DPO склонен сильно переобучаться под отдельные эстетические решения, Flow-GRPO вышел прошлой осенью, а FDFO этого июня авторы считают лучшим на сегодня описанием такого дообучения (это их мнение). Подробный разбор своего стека обещают «в ближайшие недели».
Ограничения. Модель не обучали на изображениях с отрисованным текстом (инфографика, PDF, страницы книг, слайды), такие данные отфильтрованы целиком, поэтому она не умеет писать текст и делать постеры. Из-за малого размера она хуже справляется с изображениями людей в полный рост, множеством объектов (например, шесть машин, толпы), взаимодействием нескольких людей и знаниями о мире, хотя иногда рисует такое правильно. Авторы считают, что модель побольше (например, 7 млрд параметров) и дальнейшее дообучение, вероятно, смягчат эти проблемы. В примерах неудач показаны, в частности, деформированные ноги бегуна на стартовых колодках.
Авторство. Авторы пишут, что все тексты на странице написали сами, а Claude Opus 5.5 использовали для галереи изображений и диаграмм. Карточку модели на Hugging Face и репозиторий на GitHub автоматически написал Claude Opus 5.5: ему указали внутренний экспериментальный репозиторий и поручили вынести и почистить нужный код.
Ключевые факты
- Linum, лаборатория из двух человек, выпустила экспериментальную модель P-JiT для генерации картинок по тексту; обучение обошлось примерно в $21 тыс., в заголовке на Hacker News указана лицензия Apache 2.0.
- Модель работает в пространстве пикселей без VAE: DiT на 2 млрд параметров и текстовый кодировщик на 4 млрд (замороженная Qwen3.5-4B); по словам авторов, сходится в 11 раз быстрее по числу образцов, чем Linum v2, при вчетверо более агрессивном сокращении токенов.
- Обучение: около 600 млн образцов вместо 50-100 млн в первых экспериментах, переход с 512² на 1024², постобучение вариантом FDFO с судьями-людьми.
- Ограничения по словам авторов: модель не умеет писать текст и делать постеры и хуже справляется с людьми в полный рост, толпами и знаниями о мире.
- Карточку модели на Hugging Face и репозиторий на GitHub автоматически написал Claude Opus 5.5.
Почему это важно
Релиз показывает, что маленькая команда может обучить с нуля модель генерации картинок за сумму порядка $21 тыс. и открыть её веса (лицензия указана в заголовке на Hacker News). Технически интересен отказ от VAE: по словам авторов, модель в пространстве пикселей сходится в 11 раз быстрее по числу образцов, чем предыдущая Linum v2, при вчетверо более агрессивном сокращении токенов. Для самих авторов это промежуточный шаг к следующей видеомодели.
Кому это важно
Исследователям диффузионных моделей, которым интересны пиксельные архитектуры без VAE, считыватели вдоль ствола DiT и расписание шума. Командам с небольшим бюджетом на обучение. Тем, кто следит за постобучением диффузионных моделей: Linum описывает вариант FDFO и обещает подробный разбор в ближайшие недели.
Как это применить
Авторы выложили модель как экспериментальный релиз, карточка модели есть на Hugging Face, код, на GitHub; лицензия Apache 2.0 указана в заголовке публикации на Hacker News. Использовать её для картинок с текстом (постеры, инфографика, слайды) не стоит: таких данных в обучении не было. Подробное описание архитектуры, потерь и этапов обучения на странице позволяет воспроизвести подход; таблица настроек приведена в приложении A.
Можно ли доверять
Источник, первоисточник, сами авторы, и все оценки качества, их собственные: в тексте нет количественных метрик качества изображений (FID, GenEval и т. п.) и сравнений с другими моделями, а результаты предлагается оценивать по картинкам в галерее. Фраза о том, что FDFO, лучшее описание постобучения диффузии, мнение авторов. Стоимость в заголовке Hacker News округлена до $20 тыс., в тексте указано $21 тыс.; железо и время обучения не названы.
Риски и подводные камни
Это экспериментальный релиз небольшой модели: авторы сами называют слабыми местами изображения людей в полный рост, сцены со многими объектами, взаимодействие нескольких людей и знания о мире, а текст и постеры модель не умеет вовсе. Улучшение от модели побольше и дообучения они оценивают как вероятное, не гарантированное. Карточку и репозиторий писал Claude Opus 5.5 автоматически, поэтому их содержимое стоит сверять со статьёй.