K2-Horizon: представлены шесть полностью открытых моделей от 0,9B до 375B
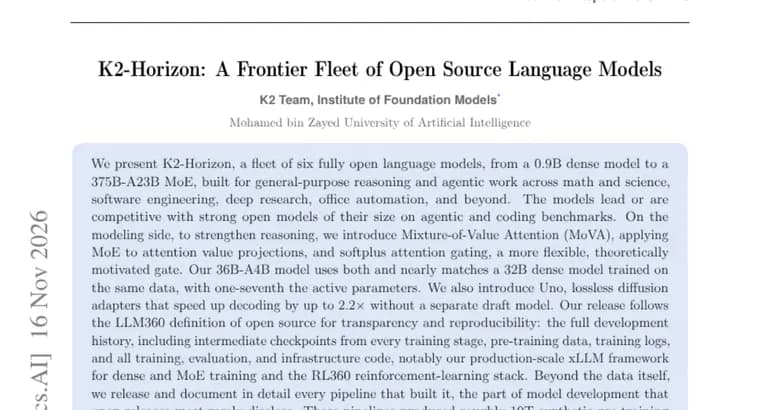
В статье представлена K2-Horizon, «флот» из шести полностью открытых языковых моделей: от плотной (dense) модели на 0,9 млрд параметров до MoE (смесь экспертов) 375B-A23B. Модели рассчитаны на универсальные рассуждения и агентные задачи: математику и науку, программную инженерию, глубокие исследования (deep research), автоматизацию офисной работы и не только. По заявлению авторов, на агентных и кодинговых бенчмарках они лидируют или не уступают сильным открытым моделям своего размера. Какие именно бенчмарки и конкуренты имеются в виду, в тексте не названо.
В архитектуре авторы предлагают два новшества, призванных усилить рассуждения. Первое, Mixture-of-Value Attention (MoVA): MoE применяется к проекциям значений (value) в механизме внимания. Второе, softplus attention gating, более гибкий и теоретически обоснованный вентиль (гейт) внимания. Модель 36B-A4B использует оба приёма и, по словам авторов, почти догоняет плотную модель на 32B, обученную на тех же данных, при одной седьмой активных параметров.
Третья разработка, Uno: адаптеры на основе диффузии, которые, как утверждают авторы, ускоряют декодирование до 2,2 раза без потерь и без отдельной черновой (draft) модели.
Главный акцент, на открытости. Релиз следует определению open source от LLM360 и включает всю историю разработки: промежуточные чекпоинты каждого этапа обучения, данные предобучения, логи обучения, а также весь код обучения, оценки и инфраструктуры. Особо выделены промышленный фреймворк xLLM для обучения плотных и MoE-моделей и стек обучения с подкреплением RL360. Кроме самих данных авторы публикуют и подробно описывают каждый конвейер их создания, ту часть разработки, которую открытые релизы раскрывают реже всего. Эти конвейеры дали примерно 10 трлн синтетических токенов предобучения; по мнению авторов, это показывает, что синтетические данные могут быть одним из главных ингредиентов предобучения в больших масштабах.
Четыре из шести моделей обучены на одном корпусе в 22 трлн токенов по единому рецепту. Это, как отмечают авторы, позволяет увидеть согласованное поведение при масштабировании и проводить контролируемые исследования влияния размера и разреженности. Все материалы доступны по адресу https://ifm.ai/k2/.
Ключевые факты
- Шесть полностью открытых моделей: от плотной 0,9B до MoE 375B-A23B, для рассуждений и агентных задач (наука, кодинг, deep research, офисная автоматизация).
- Новые приёмы: MoVA (MoE для проекций значений во внимании) и softplus-гейтинг внимания; модель 36B-A4B почти догоняет плотную 32B при одной седьмой активных параметров.
- Uno, диффузионные адаптеры, ускоряющие декодирование до 2,2 раза без потерь и без отдельной черновой модели.
- Открыта вся история разработки по определению LLM360: чекпоинты всех этапов, данные, логи, код обучения, оценки и инфраструктуры (xLLM, RL360).
- Опубликованы конвейеры данных, давшие около 10 трлн синтетических токенов; четыре модели делят корпус в 22 трлн токенов.
Почему это важно
Большинство открытых релизов ограничиваются весами и, в лучшем случае, описанием обучения. Здесь заявлена публикация полной истории разработки: промежуточных чекпоинтов, данных предобучения, логов и всего кода, включая промышленные фреймворки xLLM и RL360. Авторы подчёркивают, что раскрыли и конвейеры создания данных, то, что открытые релизы показывают реже всего. Плюс общий корпус в 22 трлн токенов у четырёх моделей даёт редкую возможность изучать масштабирование и разреженность в контролируемых условиях.
Кому это важно
Исследователям предобучения и масштабирования, командам, которые строят собственные модели и конвейеры синтетических данных, а также тем, кто занимается обучением с подкреплением и инфраструктурой обучения MoE. Интересно и разработчикам, которым нужны открытые модели разных размеров, от 0,9B до 375B-A23B, для агентных и кодинговых задач.
Как это применить
Все материалы собраны по адресу https://ifm.ai/k2/. Можно взять модели нужного размера, воспроизвести обучение по опубликованным логам, чекпоинтам и коду, использовать конвейеры синтетических данных или попробовать идеи MoVA, softplus-гейтинга и адаптеров Uno в собственных экспериментах. Лицензия в тексте не названа, поэтому условия использования стоит проверить на странице проекта.
Можно ли доверять
Источник, аннотация статьи, все утверждения о качестве принадлежат самим авторам. Названий бенчмарков, конкретных оценок и конкурирующих моделей в тексте нет, фраза «сильные открытые модели своего размера» не уточняется, поэтому заявление о лидерстве или паритете проверить по этому тексту нельзя. Имена авторов и организации в тексте не указаны. Заявленное ускорение до 2,2 раза и «почти равенство» 36B-A4B с плотной 32B стоит сверить с полным текстом статьи и независимыми замерами.
Риски и подводные камни
Заявленный паритет с сильными открытыми моделями не подкреплён в аннотации конкретными цифрами. Размеры остальных четырёх моделей и то, какие именно четыре делят корпус в 22 трлн токенов, не указаны. Не названы и затраты на обучение: вычислительный бюджет и оборудование. Доля синтетики в корпусе тоже не раскрыта: около 10 трлн токенов, это выход конвейеров, а не состав корпуса. Лицензия не указана, поэтому полная открытость на практике требует проверки.
«Помимо самих данных, мы публикуем и подробно документируем каждый конвейер, который их создал, ту часть разработки моделей, которую открытые релизы раскрывают реже всего.»
— Авторы K2-Horizon, аннотация статьи