Индекс визуального поиска по документам позволяет восстановить страницы
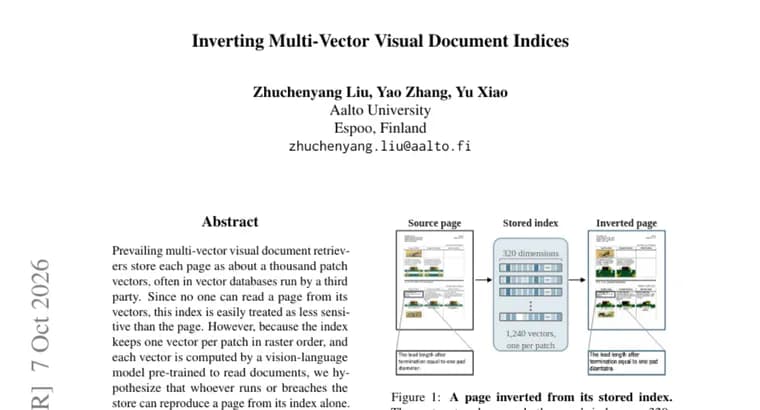
Распространённые многовекторные системы визуального поиска по документам хранят каждую страницу примерно как тысячу векторов фрагментов (патчей). Часто эти векторы лежат в векторных базах данных, которые обслуживает сторонний провайдер. Раз по векторам страницу прочитать нельзя, индекс легко считают менее чувствительным, чем сам документ.
Авторы статьи возражают: индекс хранит по одному вектору на фрагмент в растровом порядке, а каждый вектор вычисляет визуально-языковая модель, предобученная читать документы. Поэтому, как они предполагают, тот, кто обслуживает хранилище или взломал его, способен воспроизвести страницу только по индексу. Инверсию они формулируют как условную генерацию изображения документа. Всё, что нужно атаке, она выводит из самих векторов: кодировщик, форму страницы и, если векторы перемешаны, их порядок.
На бенчмарке ViDoRe v3 страницы, восстановленные из необработанных индексов, содержат 47% слов и 45% чувствительных токенов. Если использовать такую страницу как запрос к сохранённым индексам, её исходная страница оказывается первой в выдаче в 98,4% случаев.
Проверены две дешёвые меры защиты: объединение токенов (token pooling) и перемешивание векторов. Обе снижают долю восстановленных слов примерно до 8%. Но модель, которая восстанавливает порядок перемешанного индекса, поднимает долю случаев, когда исходная страница стоит первой, с 3,8% до 93,5%. Инверсия индекса после объединения токенов, по словам авторов, остаётся нерешённой задачей.
Для проверки обобщаемости ту же атаку без изменений применили к другой многовекторной системе поиска. Восстановленные страницы и там ставят исходную страницу на первое место в 70,2% случаев, хотя доля восстановленных слов остаётся ниже базового уровня метода ближайших соседей. Вывод авторов: многовекторные системы визуального поиска по документам уязвимы к инверсии через сохранённый индекс, и его нужно защищать так же, как сами документы.
Ключевые факты
- Типичная многовекторная система хранит страницу примерно как тысячу векторов патчей, нередко в базе стороннего провайдера, и такой индекс легко считают менее чувствительным, чем документ.
- На ViDoRe v3 страницы, восстановленные из необработанных индексов, содержат 47% слов и 45% чувствительных токенов; как запрос они ставят исходную страницу первой в 98,4% случаев.
- Объединение токенов и перемешивание снижают долю восстановленных слов примерно до 8%, но модель, возвращающая порядок, поднимает долю первых мест у перемешанного индекса с 3,8% до 93,5%.
- Инверсия индекса с объединением токенов остаётся открытой задачей.
- Та же атака без изменений на другой многовекторной системе даёт первое место исходной странице в 70,2% случаев, при этом доля слов ниже базового уровня метода ближайших соседей.
Почему это важно
Векторный индекс обычно воспринимают как безобидное производное от документа: по набору чисел текст не прочитать. Работа оспаривает это допущение для многовекторных систем визуального поиска: по индексу можно воссоздать значительную часть содержимого страницы, включая чувствительные токены (45% на тестовом наборе). Значит, хранить такой индекс у стороннего провайдера или в слабо защищённой базе так же рискованно, как хранить сами страницы.
Кому это важно
Командам, которые строят поиск по сканам, PDF и презентациям на основе многовекторных визуальных моделей, особенно если индексы лежат во внешних векторных базах. Также специалистам по безопасности и защите данных, которые решают, какой уровень защиты назначать индексам, и провайдерам векторных хранилищ.
Как это применить
Главный вывод авторов практический: относиться к индексу как к самим документам, то есть применять к нему те же требования к доступу, хранению и выбору провайдера. Простые меры не спасают: объединение токенов и перемешивание снижают долю восстановленных слов до примерно 8%, но перемешанный индекс удаётся упорядочить обратно, и исходная страница снова оказывается первой в 93,5% случаев. Для индексов с объединением токенов успешная инверсия в статье не показана, но авторы прямо называют эту задачу открытой, так что это не гарантия защиты.
Можно ли доверять
Источник, аннотация статьи на Hugging Face Papers. Результаты получены на бенчмарке ViDoRe v3 и описаны самими авторами. В аннотации не названы конкретные протестированные системы и не раскрыто, как устроена модель восстановления порядка, поэтому оценить воспроизводимость по одному этому тексту нельзя. О реальных взломах или атаках речи нет: это экспериментальная работа. Что именно измеряет «первое место в выдаче» и насколько атака практична вне бенчмарка, нужно смотреть в полном тексте.
Риски и подводные камни
Часть выводов, гипотеза авторов, подтверждённая экспериментом на одном бенчмарке. На другой системе доля восстановленных слов ниже базового уровня метода ближайших соседей, так что обобщаемость частичная: страница опознаётся по индексу (70,2%), но текст восстанавливается хуже. Эффективной защиты статья не предлагает, а инверсия индекса с объединением токенов остаётся нерешённой, поэтому нельзя считать такой индекс безопасным.
«Многовекторные системы визуального поиска по документам, таким образом, уязвимы к инверсии через сохранённый индекс, который следует защищать так же, как документы, которые он кодирует.»
— из аннотации статьи