IBM выпустила Granite PatchTST-FM-r2, лучшую среди открытых моделей прогноза временных рядов
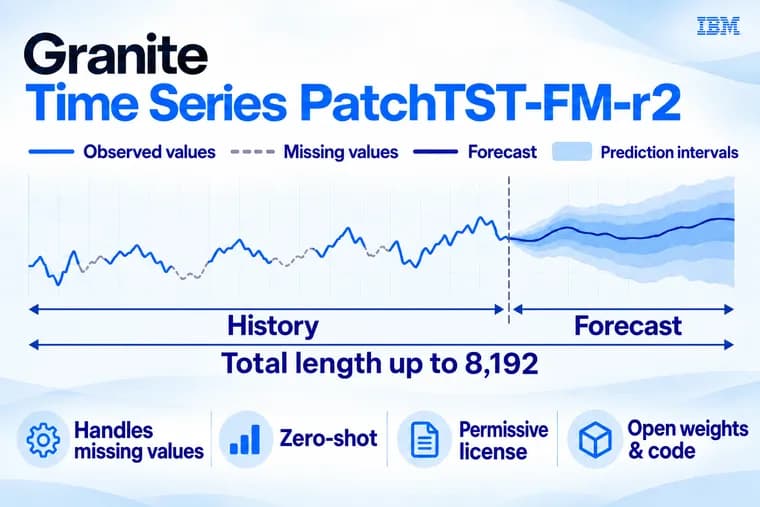
IBM выпустила Granite Time Series PatchTST-FM-r2, новое поколение модели прогноза временных рядов из семейства Granite TSFM, пришедшее на смену PatchTST-FM-r1. Модель насчитывает около 385 млн параметров и распространяется под двумя лицензиями на выбор пользователя: Apache 2.0 и OpenMDW 1.0, схема лицензирования Linux Foundation, разработанная специально для ИИ-моделей. Обе разрешают свободное использование, изменение и распространение, включая коммерческое.
Результаты опубликованы на открытом бенчмарке GIFT-Eval, который оценивает модели прогнозирования на разнородном наборе сценариев. По состоянию на 8 сентября 2026 года, если ограничить таблицу лидеров моделями без дообучения (zero-shot), воспроизводимыми и проверенными на отсутствие утечки тестовых данных, PatchTST-FM-r2 занимает 2-е место в общем зачёте, второе место и по CRPS (Continuous Ranked Probability Score, метрика качества вероятностного прогноза; среднегеометрическое значение 0,467, сразу после TimesFM-3), и по MASE (Mean Absolute Scaled Error, метрика точности точечного прогноза; среднегеометрическое значение 0,6846). При этом среди моделей той же категории (воспроизводимые, zero-shot), но именно с открытой лицензией, допускающей коммерческое использование, PatchTST-FM-r2, первая.
Если в сравнение добавить ещё и «предобученные» модели, те, которым по правилам бенчмарка разрешено включать в обучение тренировочную часть самих датасетов GIFT-Eval, PatchTST-FM-r2 всё равно остаётся близко к вершине: 3-е место по CRPS и 4-е по MASE среди воспроизводимых моделей в целом. Она обходит несколько таких предобученных моделей, включая Chronos-2, Timer-S1 и варианты Toto, хотя часть моделей-конкурентов заметно крупнее по размеру (точные размеры конкурентов в источнике не приведены).
Архитектурно PatchTST-FM-r2 сохраняет патч-представление ряда, на котором строилось всё семейство PatchTST, но меняет устройство внутренних блоков. У PatchTST-FM-r1 блок совмещал многоголовое self-attention (механизм внимания) с обычной сетью прямого распространения (feed-forward). В r2 такой блок заменили на блок типа conformer, приём из обработки речи: теперь self-attention и слой временной свёртки окружены с двух сторон «половинными» (half-step) слоями прямого распространения. Получаются два дополняющих друг друга механизма, self-attention улавливает дальние связи между патчами, а свёртка отвечает за короткие локальные закономерности; ядра свёртки в блоках чередуют размеры 3 и 5 по повторяющемуся паттерну {5, 5, 3, 3}. Дополнительно модель использует 50%-ное перекрытие патчей с весовым окном Хэмминга и сборку прогноза внахлёст (overlap-and-add), что сглаживает границы между соседними патчами; добавлена нормализация для стабильности, а число блоков в базовой сети выросло с 20 до 30. В сумме это даёт модель на ~385 млн параметров с контекстом до 8192 шагов, гибкой длиной прогноза и вероятностным выходом через 99-квантильную голову, то есть не только точечный прогноз, но и доверительные интервалы.
Обучающий корпус задокументирован и собран из четырёх источников: часть датасетов из GiftEvalPretrain; синтетические данные, сгенерированные KernelSynth с изменёнными периодическими ядрами и ограниченной аугментацией; корпус в духе TSMixup (метод, описанный в Chronos), но собранный только из датасетов вне оценочной выборки GIFT-Eval, во избежание утечки; и около 500 000 синтетических последовательностей CauKer длиной 4096 шагов каждая. IBM оговаривает: подробное описание источников не отменяет для организации собственной проверки модели и условий лицензии перед использованием в продакшне, но даёт для такой проверки заметно больше информации, чем непрозрачный корпус.
Веса модели, архитектура, инференс-пайплайн и код, нужный для воспроизведения опубликованных результатов бенчмарка, выложены в открытый доступ; новая версия обратно совместима с чекпоинтами PatchTST-FM-r1 через репозиторий Granite-TSFM. Запустить модель можно несколькими строками на Python: пакет granite-tsfm>=0.3.9, сама модель ibm-granite/granite-timeseries-patchtst-fm-r2 загружается с Hugging Face Hub, а прогноз строится через TimeSeriesForecastingPipeline, без дообучения и без отдельной настройки под задачу. Подходит любой регулярно сэмплированный ряд: спрос, показания датчиков, загрузка процессора, энергопотребление, объём транзакций, трафик, цены.
Релиз продолжает более широкую работу IBM над семейством Granite Time Series. Отдельно от этого выпуска IBM и Confluent недавно открыли ранний доступ (Early Access) к нескольким моделям того же семейства прямо внутри потоковой платформы Confluent Cloud, через Apache Flink, в стартовый набор входят PatchTST-FM-r1 (ещё предыдущая версия, не r2), FlowState-r1.1, TTM-r3 и TSPulse. Это должно позволить получать прогнозы и находить аномалии прямо в потоке данных, не разворачивая отдельное ML-окружение; цена и дата выхода из раннего доступа в источнике не названы.
Ключевые факты
- IBM выпустила Granite Time Series PatchTST-FM-r2, модель прогноза временных рядов на ~385 млн параметров, доступную на выбор под двумя открытыми лицензиями: Apache 2.0 и OpenMDW 1.0 (схема лицензирования Linux Foundation для ИИ-моделей).
- На бенчмарке GIFT-Eval (данные на 8 сентября 2026 года) модель заняла 2-е место в общем зачёте среди воспроизводимых моделей без дообучения (zero-shot) и 1-е, среди таких моделей с открытой лицензией; среднегеометрическое CRPS, 0,467 (сразу после TimesFM-3), MASE, 0,6846.
- Если добавить в сравнение «предобученные» модели, которым разрешено видеть тренировочную часть данных GIFT-Eval, PatchTST-FM-r2, 3-е место по CRPS и 4-е по MASE среди воспроизводимых моделей в целом, опережая Chronos-2, Timer-S1 и варианты Toto.
- Архитектурно r2 заменил обычные трансформерные блоки на блоки типа conformer (self-attention плюс временная свёртка), число блоков выросло с 20 до 30; контекст, до 8192 шагов, вероятностный прогноз, через 99-квантильную голову.
- Веса, архитектура, инференс-пайплайн и код для воспроизведения бенчмарка выложены в открытый доступ; модель обратно совместима с чекпоинтами PatchTST-FM-r1.
Почему это важно
Модели-фундаменты для временных рядов вроде PatchTST-FM-r2 меняют то, как строятся системы прогнозирования: вместо отдельной модели под каждый набор данных используется одна предобученная модель, которая выдаёт прогноз без дообучения (в режиме zero-shot) на данных, которых никогда не видела. У PatchTST-FM-r2 совпали два свойства, которые в таких рейтингах обычно идут порознь: она занимает верхние строчки открытого бенчмарка GIFT-Eval (2-е место в общем зачёте, 1-е, среди моделей с открытой лицензией, допускающей коммерческое использование) и при этом выложена вместе с весами, кодом и инференс-пайплайном, так что заявленный результат можно перепроверить самостоятельно, а не принять на веру. IBM также раскрыл состав обучающих данных, а не оставил его непрозрачным, для компаний, которым перед внедрением модели нужно разобраться, на чём она обучена, это отдельная ценность.
Кому это важно
В первую очередь, командам, которые прогнозируют спрос, цены, энергопотребление, трафик или показания датчиков и хотят одну предобученную модель вместо отдельной под каждый ряд данных. Отдельно, компаниям с формальным контролем происхождения моделей и лицензий: IBM прямо говорит, что задокументированный состав обучающих данных не заменяет собственную проверку модели и лицензии перед внедрением, но облегчает её по сравнению с непрозрачным корпусом. И тем, кто уже смотрит на связку с потоковой обработкой через Confluent Cloud: там недавно открыли ранний доступ к нескольким моделям семейства Granite Time Series, но пока это предыдущая версия, PatchTST-FM-r1, а не описанная здесь r2.
Как это применить
Код доступен уже сейчас: пакет granite-tsfm>=0.3.9, модель ibm-granite/granite-timeseries-patchtst-fm-r2 загружается с Hugging Face Hub, а прогноз строится через TimeSeriesForecastingPipeline, с указанием столбца дат, целевого столбца (или столбцов), длины контекста (до 8192 шагов), нужной длины прогноза и списка квантилей. Дообучение или отдельная настройка под задачу не нужны: пайплайн берёт последнюю историю ряда и сразу выдаёт прогноз с доверительными интервалами. Подходит любой регулярно сэмплированный ряд: спрос, показания датчиков, загрузка процессора, энергопотребление, объём транзакций, трафик, цены. Для потоковых сценариев есть отдельный путь через Confluent Cloud и Apache Flink, но туда пока встроена версия r1, а не r2, и это ранний доступ без объявленной цены и даты общей доступности.
Можно ли доверять
Пост опубликован от имени IBM в официальном блоге на Hugging Face, без указания конкретного автора, везде используется собирательное «мы». Ключевое отличие от типичного релизного поста: цифры привязаны к открытому стороннему бенчмарку GIFT-Eval, а не только к словам разработчиков, и вместе с моделью выложен код для воспроизведения именно этих чисел, заявленное место в рейтинге можно перепроверить самостоятельно. Источники обучающих данных тоже названы, а не скрыты. Оговорка: цифры, снимок таблицы лидеров на конкретную дату, 8 сентября 2026 года, сама IBM формулирует это как «по состоянию на», а независимого пересчёта в рамках этого материала не было, такие бенчмарки меняются по мере появления новых моделей.
Риски и подводные камни
Место в рейтинге, это снимок публичной таблицы лидеров на 8 сентября 2026 года: такие бенчмарки меняются по мере добавления новых моделей, и позиция может не удержаться. PatchTST-FM-r2, не лучшая модель вообще, а вторая в общем зачёте, сразу после TimesFM-3, и лишь третья-четвёртая, если в сравнение добавить модели, которым по правилам бенчмарка разрешено видеть тренировочную часть его собственных данных. Абсолютные показатели конкурентов, TimesFM-3, Chronos-2, Timer-S1, вариантов Toto, в источнике не приведены, названы только их место в рейтинге и цифры самой PatchTST-FM-r2, так что точный разрыв по этому материалу не проверяется. Для потокового сценария через Confluent Cloud пока нет ни цены, ни даты выхода из раннего доступа, и туда встроена версия r1, а не r2. И сама IBM оговаривает: документированный состав обучающих данных не отменяет для организации необходимости самой проверить модель и условия лицензии перед использованием в продакшне, он лишь даёт для этого больше информации, чем непрозрачный корпус.