GPT-6 Astra: бенчмарки и слухи о скрытых рассуждениях
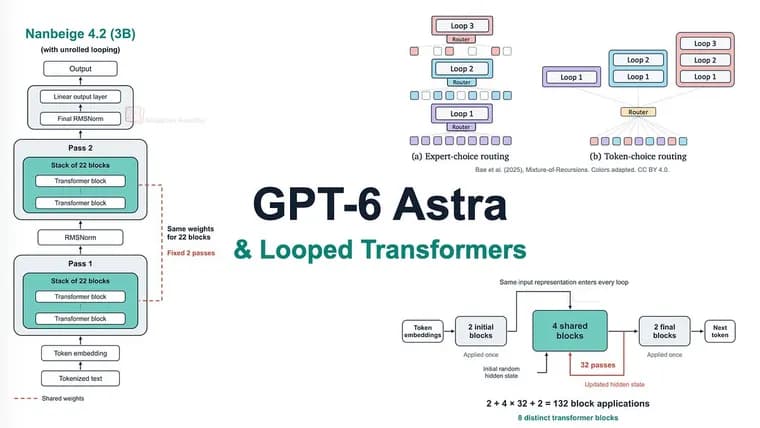
Себастьян Рашка, специализирующийся на архитектурах языковых моделей, поделился впечатлениями от новой модели OpenAI, GPT-6 Astra, которая, по его словам, вышла на прошлой неделе с большим размахом. Он называет её, по всей видимости, лучшей моделью, которой пользовался: она заметно обгоняет предыдущую GPT-5.6 в письме, математике и кодинге и особенно сильна в 3D-рендеринге и анимации. На бенчмарке ARC-AGI-3 (логические задачи и обобщение) Astra набрала 99,9% против 7,8% у GPT-5.6 Sol. По независимым индексам Artificial Analysis, Coding Agent Index v1.4 и общему Intelligence Index v4.2, модель на переднем крае, но не отрывается от конкурентов резким скачком; конкретные баллы по этим двум индексам показаны на графиках в статье. Автор отдельно отмечает, что оценки Artificial Analysis надёжнее самооценок, которые публикуют сами разработчики моделей, хотя разные бенчмарки используют разные тестовые «обвязки» (harness), и модель, настроенную под одну из них, другая может недооценивать.
Отдельный акцент, на управлении компьютером (computer use): Astra через приложение Codex/ChatGPT способна работать с графическим интерфейсом, управляя мышью и клавиатурой. В качестве демонстрации автор показал, как модель на среднем и высоком уровне «усилия» (effort: Medium и High) перерисовала его фотографию в браузерной версии MS Paint, используя курсор мыши; более высокие уровни, Extra High (сверхвысокий) и Max (максимальный), он не использовал, чтобы не тратить лишние токены. По сообщениям, на которые ссылается автор, для обучения этому OpenAI закупила десятки тысяч компьютеров Mac Mini и Mac Studio, не для обучения самой модели (для этого используются GPU), а как среду: модель получает снимки экрана macOS, предсказывает действия мышью и клавиатурой, эти действия выполняются, а по итогу успеха или неудачи модель получает сигнал обучения, аналог обучения с подкреплением на основе проверяемых наград (RLVR). Саму модель, по словам главы Nvidia, обучали на примерно 100 000 GPU Grace Blackwell. Несмотря на акцент на работу с интерфейсами, GPT-6 Astra, как пишет автор, остаётся рассуждающей моделью, она обучена с подкреплением на основе проверяемых наград и выдаёт промежуточные цепочки рассуждений, и это не смена парадигмы обучения.
За два дня до официального анонса Astra издание The Information со ссылкой на неназванные инсайдерские источники сообщило, что модель использует архитектуру «рекуррентной глубины» (в оригинале, recurrent depth, также встречается название looped transformers, «трансформеры с повторным проходом»): вместо добавления новых блоков трансформера одни и те же блоки с одинаковыми весами прогоняют промежуточные представления через себя несколько раз. Рашка подробно объясняет этот приём, он не новый, идея встречалась ещё в статье «Universal Transformers» 2018 года, и иллюстрирует его на примере открытой модели Nanbeige4.2-3B: входные данные проходят через 22 блока трансформера, а затем те же 22 блока прогоняются повторно с теми же весами, что даёт 44 применения блоков суммарно. Автор поясняет, что записал отдельное лекционное видео с разбором этого приёма и слухов о «скрытии» цепочки рассуждений и обещает вернуться к этой теме и к новым исследовательским работам дальше в статье.
Отдельно в тексте, практический совет: коллега автора, сославшись на рекомендацию, которую автор приписывает руководителю Claude Code, посоветовал по мере роста возможностей моделей архивировать или удалять часть содержимого файлов с инструкциями для агентов (AGENTS.md, SKILL.md), поскольку избыточные подсказки могут ограничивать более способные модели и вести к худшим решениям.
Ключевые факты
- OpenAI выпустила GPT-6 Astra; по словам автора, это, по всей видимости, лучшая модель, которой он пользовался, особенно сильна в 3D-рендеринге и анимации, и обгоняет предыдущую GPT-5.6 в кодинге, математике и письме.
- На бенчмарке ARC-AGI-3 (логические задачи и обобщение) Astra набрала 99,9% против 7,8% у GPT-5.6 Sol; по индексам Artificial Analysis модель на переднем крае, но не отрывается резким скачком.
- Astra умеет управлять компьютером через интерфейс (приложение Codex/ChatGPT), автор показал, как модель на среднем и высоком уровне «усилия» перерисовала его фотографию в браузерной версии MS Paint, управляя курсором мыши.
- По данным издания The Information со ссылкой на неназванные инсайдерские источники, архитектура Astra использует «рекуррентную глубину» (looped transformers), повторный прогон одних и тех же блоков трансформера с общими весами вместо добавления новых блоков; OpenAI это не подтверждала.
- Для обучения работе с компьютером OpenAI, по сообщениям, закупила десятки тысяч компьютеров Mac Mini и Mac Studio как среду для модели, а не для самого обучения (для него используются GPU); по словам главы Nvidia, саму Astra обучали на примерно 100 000 GPU Grace Blackwell.
Почему это важно
GPT-6 Astra, новая флагманская модель OpenAI и, по словам автора, по всей видимости, лучшая, которой он пользовался: она заметно обгоняет предыдущую GPT-5.6 в кодинге, математике и письме и особенно сильна в 3D-рендеринге и анимации, а на бенчмарке ARC-AGI-3 набирает 99,9% против 7,8% у GPT-5.6 Sol. Отдельно важна архитектурная линия: издание The Information со ссылкой на инсайдеров сообщило, что Astra использует «рекуррентную глубину» (looped transformers), прогон одних и тех же блоков трансформера несколько раз с общими весами вместо добавления новых слоёв. Если это подтвердится, это станет заметным отходом от простого масштабирования моделей вширь и вглубь и может быть связано со слухами о том, что модель «прячет» цепочку своих рассуждений от пользователя, вопрос, важный для доверия к рассуждающим моделям в целом.
Кому это важно
Прежде всего, исследователям и инженерам, которые следят за архитектурой языковых моделей: повторный прогон одних и тех же блоков трансформера касается прямо их работы. Разработчикам, использующим Astra через приложение Codex/ChatGPT для агентных задач и управления компьютером через интерфейс, раздел про этот режим показывает, на что сейчас способна модель. Всем, кто пишет для моделей инструкции вроде AGENTS.md и SKILL.md, в статье приводится совет коллеги автора (созвучный, по его словам, с рекомендацией руководителя Claude Code): часть таких инструкций для новых, более понимающих моделей можно архивировать или удалять. И тем, кто следит за прозрачностью рассуждающих моделей, раз вопрос о «скрытых» рассуждениях Astra остаётся открытым.
Как это применить
Практический совет из статьи: инструкции для агентов (AGENTS.md, SKILL.md) стоит периодически пересматривать, по мере того как модели лучше понимают задачу без подсказок, старые многословные инструкции могут, наоборот, мешать и вести к худшим решениям; автору это посоветовал коллега, сославшись на такую же рекомендацию руководителя Claude Code. При сравнении моделей полезно ориентироваться на независимые бенчмарки вроде индексов Artificial Analysis, а не только на цифры, которые публикует сам разработчик модели, по словам автора, они надёжнее самооценок. Тестируя саму Astra на задачах с управлением компьютером, стоит учитывать: автор показывал результат на среднем и высоком уровне «усилия» (effort), более высокие уровни он не использовал, чтобы не тратить лишние токены, значит, у модели есть запас возможностей выше показанного, но и цена в токенах выше.
Можно ли доверять
Автор, по собственному описанию, специалист по архитектурам языковых моделей, и большую часть материала пишет по личному опыту работы с Astra. Независимым источником автор называет индексы Artificial Analysis, по его словам, они надёжнее самооценок, которые публикуют сами разработчики моделей. Единственная пара чисел в пересказе, 99,9% против 7,8% на ARC-AGI-3, к этим индексам не относится, и источник этих чисел в тексте не назван. При этом ключевое архитектурное утверждение, что Astra использует «рекуррентную глубину», источник сам называет слухом: оно взято из статьи издания The Information со ссылкой на неназванные инсайдерские источники, и OpenAI его не подтверждала. Автор поясняет, что разбирает вопрос о «скрытии» цепочки рассуждений в отдельном лекционном видео, вставленном в статью, и обещает вернуться к этой теме и к новым исследовательским работам дальше в тексте.
Риски и подводные камни
Главный риск, спутать слух с фактом: то, что Astra использует «рекуррентную глубину», не подтверждено OpenAI, а исходит от анонимных инсайдеров через The Information. Цифра «около 100 000 GPU Grace Blackwell», это личное замечание главы Nvidia, а не официальное раскрытие OpenAI, и само по себе не доказывает архитектуру модели. Если слухи о «скрытой» цепочке рассуждений верны, это снижает прозрачность модели для пользователей, которые проверяют ответ по ходу рассуждений модели, именно этот вопрос статья поднимает, но не закрывает. Наконец, автор сам предупреждает: разные бенчмарки используют разные тестовые «обвязки» (harness), и модель, дообученную под одну из них, другая может недооценивать, так что место в рейтингах вроде Intelligence Index не стоит читать как окончательный вердикт о силе модели.
«GPT-6 Astra, и, вероятно, любая языковая модель в обозримом будущем, остаётся рассуждающей моделью.»
— Себастьян Рашка