Gemini 4 Neon заняла первое место в рейтинге Models Engineering Index
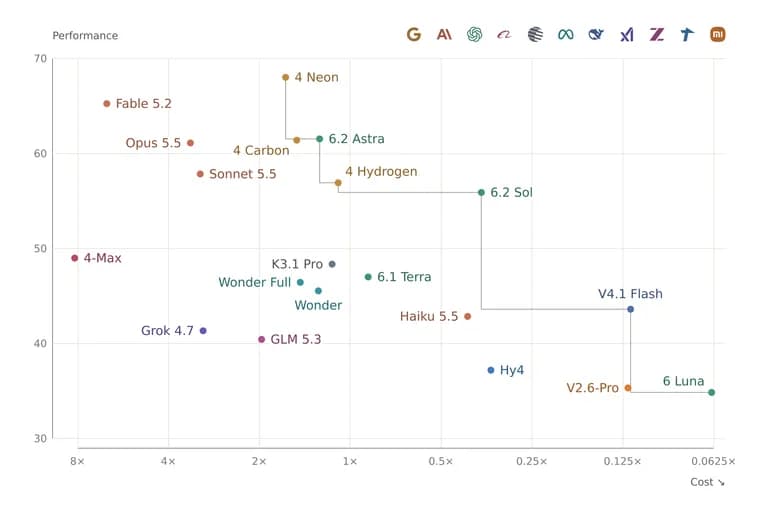
Models Engineering Index (Mei), веб-рейтинг, который сводит опубликованные результаты тестов (бенчмарков) в один индекс для каждой языковой модели. Первое место в нём занимает модель Google 4 Neon (в заголовке обсуждения на HN она названа Gemini 4 Neon) с индексом 68,0. На втором месте Fable 5.2 от Anthropic с 65,3, на третьем 6.2 Astra от OpenAI с 61,5, на четвёртом 4 Carbon от Google с 61,4, на пятом Opus 5.5 от Anthropic с 61,1.
В таблице рядом с индексом указаны относительная стоимость и расход токенов: за единицу (1×) принята типичная модель. У 4 Neon стоимость 1,6× и расход токенов 0,83×. У Fable 5.2, 6,4× и 2,1×. У 6.2 Astra, 1,3× и 0,29×, у 4 Carbon, 1,5× и 0,89×, у Opus 5.5, 3,4× и 1,9×. Это не цены в долларах, а величины относительно типичной модели.
Как считается индекс. Результаты каждого теста стандартизируют, затем оценивают одновременно эффект модели и эффект теста. Благодаря этому модель не получает бонус за то, что проходила только лёгкие тесты, и не теряет очки за те тесты, которые пропустила. Итог масштабируют так, чтобы среднее по моделям было 50, а стандартное отклонение 10. Стоимость и расход токенов подгоняют тем же способом в логарифмической шкале. Данные берутся у Cognition, Cursor, Laude Institute и Vals AI; исходный код проекта лежит на GitHub.
Большая часть страницы, оговорки самих авторов. Они прямо пишут, что индекс «далёк от совершенства», и над его улучшением идёт работа. Модели проверялись на разных наборах тестов, поэтому часть оценок опирается на гораздо меньше данных, чем другие. Доверительных интервалов (error bars) нет, так что небольшие разрывы между моделями ничего не значат. Оценки относительны: если добавить или убрать модели из списка, баллы сдвинутся. Все тесты имеют одинаковый вес независимо от размера и надёжности. Стоимость, это заявленная стоимость прогона каждого теста по ценам того времени, а не цена на вашей задаче. Результаты воспроизведены как опубликованные, независимо не проверены и могут быть искажены утечкой тестов в обучение или подгонкой под них. Наконец, тесты, лишь приближение к реальной инженерной работе.
Ключевые факты
- Models Engineering Index (Mei) ставит 4 Neon от Google на первое место: индекс 68,0 против 65,3 у Fable 5.2 от Anthropic.
- Дальше идут 6.2 Astra (OpenAI, 61,5), 4 Carbon (Google, 61,4) и Opus 5.5 (Anthropic, 61,1).
- Относительная стоимость и расход токенов: у 4 Neon 1,6× и 0,83×, у Fable 5.2, 6,4× и 2,1× от типичной модели (1×).
- Индекс шкалирован так, что среднее по моделям равно 50, стандартное отклонение, 10; данные взяты у Cognition, Cursor, Laude Institute и Vals AI.
- Авторы сами предупреждают: доверительных интервалов нет, малые разрывы не значимы, результаты не проверены независимо.
Почему это важно
Сводные рейтинги пытаются заменить россыпь отдельных тестов одним числом, и по этому числу выбирают модель для инженерных задач. По данному индексу модель Google 4 Neon оказалась выше всех: 68,0 против 65,3 у ближайшего конкурента, Fable 5.2 от Anthropic. Заметно и соотношение затрат: при более высоком индексе у 4 Neon относительная стоимость 1,6× против 6,4× у Fable 5.2, а расход токенов 0,83× против 2,1×. Впрочем, значимость разрыва в 2,7 пункта по тексту страницы оценить нельзя: авторы пишут, что небольшие разрывы не значимы.
Кому это важно
Командам и разработчикам, которые подбирают модель для программирования и инженерных задач и хотят быстро сравнить доступные варианты по качеству и относительной стоимости. Также тем, кто следит за конкуренцией лабораторий: в верхней пятёрке таблицы, Google (два места), Anthropic (два места) и OpenAI (одно).
Как это применить
Использовать индекс как ориентир для короткого списка кандидатов, а не как окончательный выбор. Стоимость и расход токенов в таблице относительны (типичная модель = 1×) и отражают заявленную стоимость прогонов тестов, а не цену на вашей нагрузке. Поэтому финалистов стоит проверить на собственных задачах и посчитать реальные расходы. Сведения о тарифах или доступности моделей в источнике не приводятся.
Можно ли доверять
С осторожностью. Страница сама признаёт, что индекс далёк от совершенства: нет доверительных интервалов, модели тестировались на разных наборах бенчмарков, все тесты взвешены одинаково, а результаты взяты как опубликованные и независимо не проверены. В тексте не названы ни состав тестов, ни их число, ни дата рейтинга, ни авторы индекса помимо имени в адресе страницы. Строки таблицы мы видели в сокращённом пересказе страницы, а не дословно, поэтому цифры стоит сверить на самой странице. Название «Gemini 4 Neon» взято из заголовка обсуждения; в таблице модель значится как «4 Neon» от Google.
Риски и подводные камни
Оценки относительны: добавление или удаление моделей из списка сдвигает баллы. Возможны утечка тестов в обучение и подгонка под них, это отмечено на странице. Тесты, лишь приближение к реальной инженерной работе, поэтому первое место в индексе не гарантирует лучший результат на вашем проекте. Из-за отсутствия доверительных интервалов нельзя уверенно утверждать, что 4 Neon действительно лучше Fable 5.2, а не просто чуть выше по случайным причинам.
«Этот индекс далёк от совершенства, и над его улучшением ведётся работа.»
— страница Models Engineering Index