Fable 5.2 от Anthropic возглавила Remote Labor Index: 41,3% фриланс-заданий
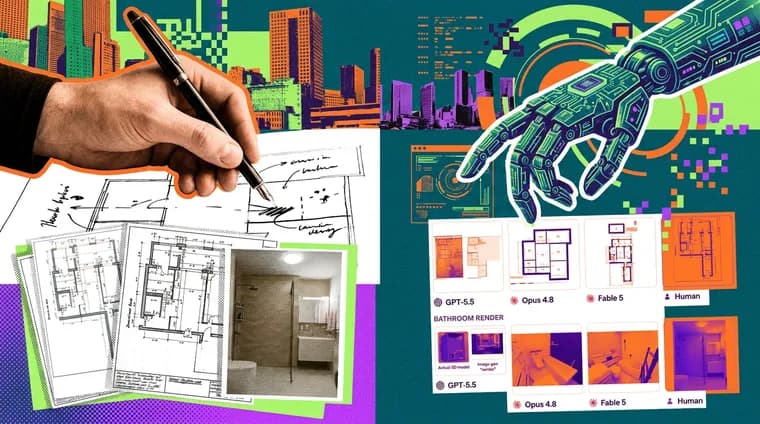
Новая модель Anthropic Fable 5.2 возглавила Remote Labor Index (RLI), тест от Scale Labs и Center for AI Safety (CAIS). Она выполнила 41,3% реальных фриланс-заданий на уровне, который принял бы платящий заказчик. По данным издания The Decoder, это резкий скачок: когда тест запускали около года назад, лучшая система того времени, Manus, справлялась лишь с 2,5% задач. Fable 5.2 выполняет более чем в 16 раз больше профессиональных заданий. Скачок велик и по сравнению с недавними замерами. В июле лидировала Fable 5, более старая модель того же семейства, примерно с 16%. Тогда это уже считалось большим шагом: лучшие агенты за восемь месяцев более чем вчетверо увеличили долю заданий, выполненных на профессиональном уровне. Через четыре месяца Fable 5.2 набрала 41,3%, то есть примерно в 2,5 раза больше июльского результата Fable 5. Прямой предшественник, Fable 5.1, набрал чуть меньше 18%, и Fable 5.2 выполняет более чем вдвое больше заданий. Следующие места в текущей таблице: Opus 5.5 от Anthropic, 21,25% и GPT 6 Astra от OpenAI, 20,83%. Fable 5.2 работает почти вдвое успешнее ближайших конкурентов на рынке. Сильнейшая модель Google в тесте, Gemini Argon 4, на пятом месте с 17,08%, а старые модели вроде GPT-5.2 или Gemini 3 Pro остаются ниже 3%. По словам Scale Labs в X, наибольший прирост Fable 5.2 дала в монтаже аудио и музыки, проектировании архитектуры и интерьеров и создании 3D-моделей. Агент также справляется с длинными сложными проектами, которые прежние лидеры регулярно проваливали. Почти 50 успешных выполнений Fable 5.2, это задания, которые ни один ИИ-агент в тесте раньше не решал. При этом, как сообщает Scale Labs, ИИ по-прежнему почти не справляется с другими задачами, прежде всего с промышленным дизайном изделий и анимацией. Когда агенты терпят неудачу, по словам исследователей, они обычно выдают работу любительского качества, неполные результаты, неработающие файлы или противоречивые проекты. В отличие от привычных тестов, проверяющих отдельные навыки, RLI охватывает целые рабочие задания. В набор входят 240 завершённых проектов 358 проверенных специалистов с платформы Upwork, их общая стоимость, около $144 000. Один проект стоит в среднем $632,60, а живому фрилансеру на него нужно в среднем чуть меньше 29 часов. Задачи, от видеомонтажа до CAD-проектирования, разработки игр и анализа данных. Агентам дают виртуальное рабочее место с профессиональными программами вроде Blender, GIMP и Audacity и специализированные ИИ-инструменты для генерации изображений, звука и видео. Успех проверяют вручную: обученные эксперты открывают присланные файлы в профессиональных программах и сравнивают результат ИИ с работой, которую сдал живой фрилансер. Попытки CAIS автоматизировать эту трудоёмкую проверку с помощью другого ИИ пока не удались: ИИ-рецензенты почти не умеют работать в профессиональных программах, поэтому их обманывают внешне аккуратные, но технически негодные работы, и они сильно завышают оценки моделям.
Ключевые факты
- Fable 5.2 от Anthropic заняла первое место в Remote Labor Index (Scale Labs и CAIS) с 41,3% выполненных реальных фриланс-заданий.
- Год назад лучшая система, Manus, получила 2,5%: Fable 5.2 выполняет более чем в 16 раз больше заданий; у Fable 5 в июле было около 16%, у Fable 5.1, чуть меньше 18%.
- Ближайшие конкуренты: Opus 5.5 от Anthropic, 21,25%, GPT 6 Astra от OpenAI, 20,83%, Gemini Argon 4 от Google, 17,08% (пятое место).
- Набор, 240 проектов 358 специалистов с Upwork общей стоимостью около $144 000; проверяют результаты вручную, автоматическая проверка другим ИИ пока не работает.
- По данным Scale Labs, сильнее всего прирост в аудио и музыке, архитектуре и интерьерах, 3D-моделях; слабее всего, промышленный дизайн и анимация.
Почему это важно
Тест RLI измеряет не отдельные навыки, а способность ИИ-агентов выполнять целые рабочие задания так, чтобы заказчик принял результат. Рост лучшего результата с 2,5% год назад до 41,3% показывает, как быстро агенты приближаются к практической работе. Fable 5.2 при этом почти вдвое опережает ближайших конкурентов (Opus 5.5, 21,25%, GPT 6 Astra, 20,83%) и более чем вдвое, Fable 5.1 (чуть меньше 18%). Почти 50 успешных выполнений, это задания, которые раньше не решал ни один агент в тесте.
Кому это важно
Фрилансерам и заказчикам на платформах вроде Upwork: набор составлен из реальных проектов проверенных специалистов, а типичный проект стоит в среднем $632,60 и занимает у человека почти 29 часов. Особенно заметен прирост в областях, которые Scale Labs называет сильнейшими для Fable 5.2: аудио и музыка, архитектура и интерьеры, 3D-модели. Также материал интересен разработчикам агентов и тем, кто выбирает модель для автоматизации профессиональных задач.
Как это применить
Результат стоит читать как ориентир по видам задач, а не как обещание выполнить любой заказ: по словам Scale Labs, ИИ по-прежнему почти не справляется с промышленным дизайном и анимацией. Среда теста, виртуальное рабочее место с Blender, GIMP, Audacity и ИИ-инструментами для изображений, звука и видео; её можно считать примером того, как оснащают агентов для профессиональной работы. Сроки выхода Fable 5.2, доступ к ней и цены в источнике не названы.
Можно ли доверять
Это пересказ материала The Decoder. Сильные и слабые стороны модели в нём приписаны Scale Labs (заявление в X), заявлений самой Anthropic в источнике нет. Цифры по таблице лидеров даны изданием, самостоятельно мы их не проверяли. Сам тест строится на ручной проверке обученными экспертами, что надёжнее автоматической оценки, но 41,3%, доля от 240 проектов одного набора, а не общая мера способностей модели.
Риски и подводные камни
Набор небольшой, 240 проектов, поэтому результат относится именно к нему. Проверка ручная и трудоёмкая: попытки CAIS заменить её другим ИИ пока не удались, потому что ИИ-рецензенты не умеют работать в профессиональных программах, их обманывают внешне аккуратные, но технически негодные работы, и они завышают оценки. Ошибки агентов, по словам исследователей, выглядят как любительская работа, неполные результаты, неработающие файлы или противоречивые проекты, то есть без человеческой проверки полагаться на результат рискованно.