DeepSeek выпустила V4.1-Flash, компактную модель с пониманием изображений
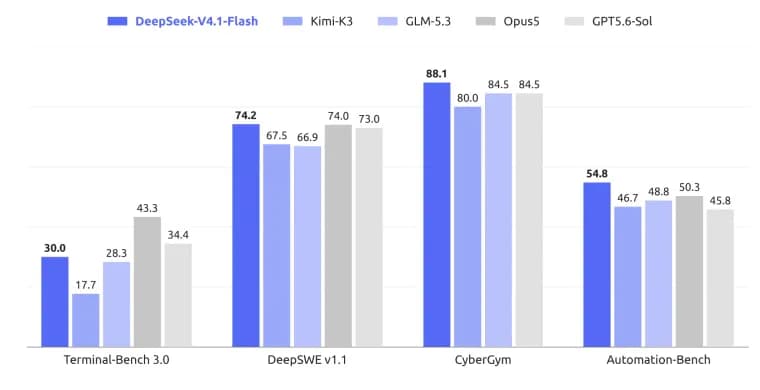
DeepSeek объявила о выпуске DeepSeek-V4.1-Flash, самой компактной модели в новом архитектурном семействе компании, с нативной поддержкой изображений (модель понимает картинки без отдельной надстройки). По словам DeepSeek, модель спроектирована так, чтобы давать больше возможностей, быстрее выполнять вывод (инференс), выдерживать более высокую нагрузку по запросам и в перспективе масштабироваться до более крупных версий. V4.1-Flash уже работает в API компании, доступ к ней открывается указанием модели deepseek-flash. Прежние модели V4-Flash и V4-Flash-Vision-Exp сняты с поддержки: для совместимости вызовы по их старым именам (deepseek-v4-flash, deepseek-v4-flash-vision-exp) пока автоматически перенаправляются на V4.1-Flash.
Технически в основе модели, новая архитектура, которую DeepSeek называет «каузальный кодировщик-декодировщик» (Causal Encoder, Decoder). Общий размер модели в архитектуре смеси экспертов (MoE), 552 млрд параметров, но активными при этом остаются лишь 8 млрд параметров на входе и 16 млрд на выходе. По утверждению DeepSeek, новые методы предобучения в сочетании с более масштабным обучением с подкреплением на этапе постобучения дают результаты тестов (бенчмарков) выше, чем у флагманских моделей компании, включая V4-Pro, конкретные названия тестов и числовые показатели DeepSeek не привела.
Отдельно компания выделяет экономию на кэше ключей-значений (KV-cache): по сравнению с предыдущим поколением моделей, V4.1-Flash требует вчетверо меньше памяти HBM и в восемь раз меньше места на SSD для хранения кэша. DeepSeek поясняет, что оплата попаданий в кэш (cache-hit) часто составляет значительную часть расходов на работу ИИ-агентов, и сжатие кэша заметно снижает эти издержки.
По данным тестов нескольких сторон, на которые ссылается DeepSeek (без уточнения, кто именно их проводил), V4.1-Flash опережает V4-Pro по производительности, стоимости, скорости и суммарному времени выполнения задач. На этом основании компания начинает поэтапный отказ от V4-Pro: с 04:00 UTC 14 сентября 2026 года все запросы к deepseek-v4-pro начнут автоматически маршрутизироваться на V4.1-Flash, по тарифам V4.1-Flash. Так будет продолжаться до выхода модели V4.1-Pro, дата релиза которой не названа.
Одновременно DeepSeek снижает цены на API: новые, более низкие тарифы вступили в силу с 04:00 UTC 10 сентября 2026 года, а расценки вне пиковой нагрузки составляют половину от пиковых, конкретные суммы в долларах или за токены компания не назвала. На момент запуска модель уже полностью поддерживают официальные партнёры DeepSeek, WorkBuddy_AI (в том числе продукт Codebuddy) и opencode. Компания также заявила о планах теснее работать с сообществом разработчиков открытого кода над поддержкой инференса V4.1-Flash и рассмотреть дополнительные варианты развёртывания; тех, кто планирует крупное развёртывание, например, на 2000 GPU с кластером хранения, DeepSeek приглашает связаться напрямую. Ссылки на карточку модели и технический отчёт о ней компания разместила на Hugging Face.
Ключевые факты
- DeepSeek выпустила DeepSeek-V4.1-Flash, самую компактную модель в новом архитектурном семействе компании, с нативной поддержкой изображений; модель уже работает в API под именем deepseek-flash и заменила собой модели V4-Flash и V4-Flash-Vision-Exp.
- Архитектура «каузальный кодировщик-декодировщик»: при общем размере модели в 552 млрд параметров (MoE) активны лишь 8 млрд параметров на входе и 16 млрд на выходе.
- Кэш ключей-значений (KV-cache) требует вчетверо меньше памяти HBM и в восемь раз меньше места на SSD, чем у предыдущего поколения моделей DeepSeek.
- По тестам нескольких сторон, на которые ссылается DeepSeek, V4.1-Flash опережает V4-Pro по производительности, стоимости и скорости; с 14 сентября 2026 года весь трафик V4-Pro начнут переводить на V4.1-Flash по её тарифам, до выхода V4.1-Pro.
- Новые, более низкие цены на API действуют с 10 сентября 2026 года, тарифы вне пиковой нагрузки, половина от пиковых; партнёры WorkBuddy_AI (Codebuddy) и opencode уже полностью поддерживают модель.
Почему это важно
DeepSeek продолжает выпускать новые версии моделей в плотном темпе и на этот раз меняет не только качество, но и архитектурный подход: вместо отдельной надстройки для работы с изображениями, какой была прежняя V4-Flash-Vision-Exp, понимание изображений встроено в саму модель, а новая схема кодировщика-декодировщика резко сокращает долю активных параметров относительно общего размера. По собственным данным компании, это даёт не просто дополнительную функцию, а более дешёвую и быструю замену прежнему флагману V4-Pro, DeepSeek заявляет, что нашла способ снизить стоимость инференса, не жертвуя качеством. Для рынка ИИ-моделей это ещё один шаг в гонке за снижение цены при сохранении возможностей, которую активно ведут китайские разработчики.
Кому это важно
В первую очередь, разработчикам и компаниям, которые уже используют API DeepSeek для агентов и мультимодальных сценариев: для них смена модели происходит частично автоматически, через переадресацию старых идентификаторов, но требует проверки, что качество ответов не изменилось. Дальше, пользователям модели V4-Pro: с 14 сентября их трафик начнёт идти через V4.1-Flash без явного действия с их стороны. Отдельно это касается официальных партнёров DeepSeek, WorkBuddy_AI с продуктом Codebuddy и opencode, которые уже интегрировали поддержку модели, а также компаний, рассматривающих крупные инфраструктурные развёртывания на собственных мощностях.
Как это применить
Чтобы получить доступ к V4.1-Flash через API DeepSeek, нужно указать модель deepseek-flash; вызовы со старыми именами deepseek-v4-flash и deepseek-v4-flash-vision-exp пока продолжат работать благодаря временной переадресации, но полагаться на них надолго не стоит. Для экономии стоит переносить несрочные, фоновые нагрузки на время вне пиковых часов, тариф там вдвое ниже пикового. Пользователям V4-Pro отдельных действий не требуется: с 14 сентября 2026 года их запросы автоматически пойдут через V4.1-Flash по её тарифам, и это продлится, пока не выйдет V4.1-Pro. Компаниям, которые планируют развёртывание на тысячах GPU (DeepSeek приводит пример, 2000 GPU с кластером хранения), стоит написать напрямую в компанию, как предлагает объявление.
Можно ли доверять
Источник, официальный аккаунт DeepSeek в X (Twitter), то есть это собственное заявление компании о своём продукте, а не независимая проверка. Цифры по архитектуре (552 млрд параметров, 8 и 16 млрд активных, экономия кэша в 4 и 8 раз) DeepSeek приводит от своего имени, без ссылки на внешний аудит. Утверждение, что V4.1-Flash опережает V4-Pro по производительности, стоимости и скорости, компания подкрепляет фразой о «тестах нескольких сторон», но не называет ни сами тесты, ни конкретные показатели, ни то, кто их проводил, так что проверить это утверждение по тексту анонса нельзя. Абсолютных цифр по цене API, в долларах или за токены, в объявлении тоже нет, только относительное соотношение «вне пика вдвое дешевле пика».
Риски и подводные камни
Главный риск, недоказанность заявлений о превосходстве над V4-Pro: без названий тестов и конкретных цифр это утверждение остаётся маркетинговым до появления независимых замеров. Второй риск, принудительность перехода: начиная с 14 сентября 2026 года весь трафик V4-Pro автоматически пойдёт через V4.1-Flash, и пользователям, которых устраивало именно поведение V4-Pro, придётся заметить разницу постфактум, а не выбрать переход осознанно. Третье, срок этого переходного периода не определён: DeepSeek не назвала дату выхода V4.1-Pro, то есть неизвестно, сколько по времени V4-Pro будет фактически недоступна в исходном виде. И четвёртое, реальную экономию по цене оценить пока нельзя: компания говорит о более низких тарифах и о том, что цена вне пика вдвое ниже пиковой, но абсолютных сумм не приводит.