Cerebras показала, как делит Kimi K3 на 59 пластин WSE-3T
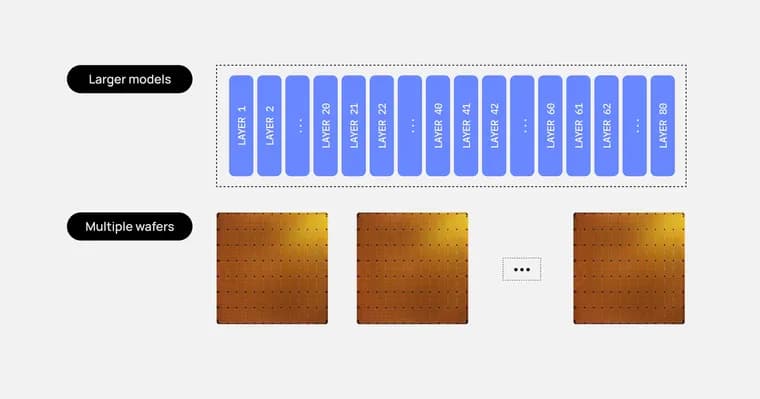
Cerebras опубликовала технический разбор того, как компания запускает модели с триллионом параметров и больше на своих чипах размером с кремниевую пластину (wafer-scale, WSE-3T). Проблема в том, что на одной пластине WSE-3T лежит 44 ГБ встроенной памяти, а для одних только весов моделей уровня триллиона параметров нужны терабайты. Cerebras утверждает, что делит такую модель между несколькими пластинами и добивается скорости 1000-2000+ токенов в секунду на моделях с несколькими триллионами параметров.
В качестве иллюстрации взята открытая модель Kimi K3: около 3 трлн параметров, 69 слоёв с линейным вниманием и 24 плотных слоя (с полным вниманием). По данным Cerebras, Kimi K3 набирает 88,3% на Terminal-Bench 2.1 (у GPT-5.6 Sol, 88,8%) и 91,2% на BrowseComp (у GPT-5.6 Sol, 90,4%). Это цифры из поста самой Cerebras, без независимой проверки. В примере принято: средний запрос 256k токенов, веса в 4-битном квантовании, KV-кэш (хранилище ключей и значений внимания) в 8 битах.
Расчёт идёт так. Если хранить 3 трлн параметров по 4 бита и разделить на 93 слоя, каждый слой занимает около 16 ГБ. Плотному слою нужно место под KV-кэш каждого активного запроса, поэтому на пластину ставят один плотный слой, а остаток памяти отдают под кэш. Слою с линейным вниманием отдельный большой кэш не нужен: он держит небольшое состояние фиксированного размера на запрос независимо от длины контекста, поэтому на пластину помещаются два таких слоя (2 × 16 ГБ = 32 ГБ из 44 ГБ). Итого 35 пластин под 69 линейных слоёв и 24 пластины под 24 плотных: 35 + 24 = 59 пластин.
Между пластинами передаются только активации (промежуточные результаты), веса не двигаются, а слои в большинстве случаев не приходится дробить между пластинами. Передача идёт по RDMA поверх Ethernet, примерно 2 микросекунды на переход. Каждая пластина работает как станция конвейера: веса её слоёв остаются на месте, а результаты запроса переходят от станции к станции.
Cerebras отвечает на возможное возражение, что пластины простаивают в ожидании токена, то есть система работает с размером пакета, равным единице. По её словам, нет: конвейер заполняют разными запросами, пока этап 3 обрабатывает токен запроса A, этап 2 занят запросом B, а этап 1, запросом C. В примере этап, это слой, а в производстве Cerebras применяет гораздо более мелкие этапы и их заметно больше. Каждый этап может обрабатывать и микро-пакет (небольшую группу запросов): число запросов в полёте примерно равно числу этапов, умноженному на размер микро-пакета. Меньшие микро-пакеты ускоряют каждый запрос, большие повышают суммарную пропускную способность.
Максимальное число одновременных запросов задаёт объём встроенной памяти, выделенной под KV-кэш: он считается только для плотных слоёв (остаток памяти пластины после плотного слоя делится на кэш одного запроса в 256k). Сами формулы и итоговое число запросов в посте не приведены. Cerebras добавляет, что ни число параллельных запросов, ни размер пакета не показывают реальную эффективность; осмысленнее мерить суммарную пропускную способность в токенах на единицу мощности (например, токенов в секунду на мегаватт) при одной и той же скорости генерации. Тот же подход, по словам компании, масштабируется на более крупные модели: считаем память под веса и состояние запросов, раскладываем по пластинам и связываем конвейером.
Ключевые факты
- Одна пластина WSE-3T несёт 44 ГБ встроенной памяти, а веса триллионных моделей занимают терабайты, поэтому Cerebras делит модель между несколькими пластинами в конвейере.
- В расчётном примере для Kimi K3 (около 3 трлн параметров, 69 линейных и 24 плотных слоя, 4-битные веса) слой весит около 16 ГБ: на пластину помещаются два слоя с линейным вниманием или один плотный слой, что даёт 35 + 24 = 59 пластин.
- Между пластинами передаются только активации по RDMA поверх Ethernet, примерно 2 мкс на переход; веса остаются на месте.
- Конвейер заполняют разными запросами, так что система не работает с размером пакета, равным единице; число одновременных запросов ограничено памятью под KV-кэш плотных слоёв.
- Cerebras заявляет скорость 1000-2000+ токенов в секунду для моделей с несколькими триллионами параметров и предлагает сравнивать системы по токенам на единицу мощности.
Почему это важно
Модели уровня триллиона параметров не помещаются в память одного ускорителя, и вопрос раскладки по оборудованию становится центральным для их запуска. Cerebras подробно показывает свою схему: конвейер из пластин WSE-3T, где веса неподвижны, а между устройствами ходят только активации. В качестве примера взята открытая Kimi K3, которая, по данным самой Cerebras, на двух тестах находится вплотную к GPT-5.6 Sol (88,3% против 88,8% на Terminal-Bench 2.1 и 91,2% против 90,4% на BrowseComp).
Кому это важно
Инженерам по инференсу и тем, кто выбирает платформу для запуска крупных моделей и сравнивает подходы к памяти и конвейерам. Также читателям, которым интересно, как устроены чипы размером с пластину и чем они отличаются от привычных GPU-кластеров. Для обычных пользователей нейросетей пост скорее объясняет, откуда берётся заявленная скорость.
Как это применить
Принцип расчёта можно перенести на свои оценки: размер слоя = число параметров × разрядность / число слоёв; затем смотреть, сколько слоёв помещается в память устройства, и отдельно считать кэш для слоёв с полным вниманием. В конце поста Cerebras приглашает попробовать бесплатный API (cloud.cerebras.ai) или обратиться в отдел продаж; цены и доступность Kimi K3 на платформе в тексте не указаны.
Можно ли доверять
Это материал самой Cerebras, то есть собственная инженерная публикация компании. Цифры в нём иллюстративные: 59 пластин, результат расчёта с принятыми допущениями (контекст 256k, 4-битные веса, 8-битный KV-кэш), а не описание реальной боевой конфигурации; в продакшене этапы мельче и их больше. Результаты Kimi K3 в тестах приведены со слов Cerebras без методики и независимого подтверждения. Скорость 1000-2000+ токенов в секунду дана как общее заявление для моделей с несколькими триллионами параметров, а не как измерение для Kimi K3.
Риски и подводные камни
В посте нет сравнения с GPU-системами и цифр по токенам на мегаватт, хотя именно эту метрику компания называет главной. Не указано и число одновременных запросов для конфигурации из 59 пластин, так что оценить ёмкость такой системы по тексту нельзя. Расчёт зависит от допущений: другой размер запроса, разрядность или точность квантования изменят число пластин и объём кэша.